Redis有哪些数据类型
String
常用命令: set,get,decr,incr,mget 等
String数据结构是简单的key-value类型,value其实不仅可以是String,也可以是数字。 常规key-value缓存应用
Hash
常用命令: hget,hset,hgetall 等。
hash 是一个 string 类型的 field 和 value 的映射表,这个是类似map的一种结构,这个一般就是可以将结构化的数据,比如一个对象(前提是这个对象没嵌套其他的对象)给缓存在redis里,然后每次读写缓存的时候,可以就操作hash里的某个字段。
key=150
value={
  “id”: 150,
  “name”: “zhangsan”,
  “age”: 20
}
List
常用命令: lpush,rpush,lpop,rpop,lrange等
可以存储一些有序列表数据,比如微博的关注列表,粉丝列表,
Set
常用命令: sadd,spop,smembers,sunion 等
set 无序集合,自动去重,当然也可以基于jvm内存里的HashSet进行去重,但是如果某个系统部署在多台机器上,得基于redis进行全局的set去重
Sorted Set
常用命令: zadd,zrange,zrem,zcard等
排序的set,去重但是可以排序,写进去的时候给一个分数,自动根据分数排序。例如排行榜:将每个用户以及其对应的什么分数写入进去,zadd board score username,接着zrevrange board 0 99,就可以获取排名前100的用户;zrank board username,可以看到用户在排行榜里的排名
Redis的单线程模型
redis有一个文件事件处理器,包含多个socket,IO多路复用程序,文件时间分派器,事件处理器(命令请求处理器,命令回复处理器,连接应答处理器)
客户端请求redis的server socket请求建立连接,当然也存在多个客户端同时请求,并发产生不同的操作,每个操作对应不同的文件事件,IO多路复用程序会监听多个socket,放在同一个队列中进行排队,每次从队列中取出一个socket给事件分派器,事件分派器把socket给对应的事件处理器,当事件处理完之后,IO多路复用程序才会将队列中的下一个socket给事件分派器。文件事件分派器会根据每个socket当前产生的事件,来选择对应的事件处理器来处理。
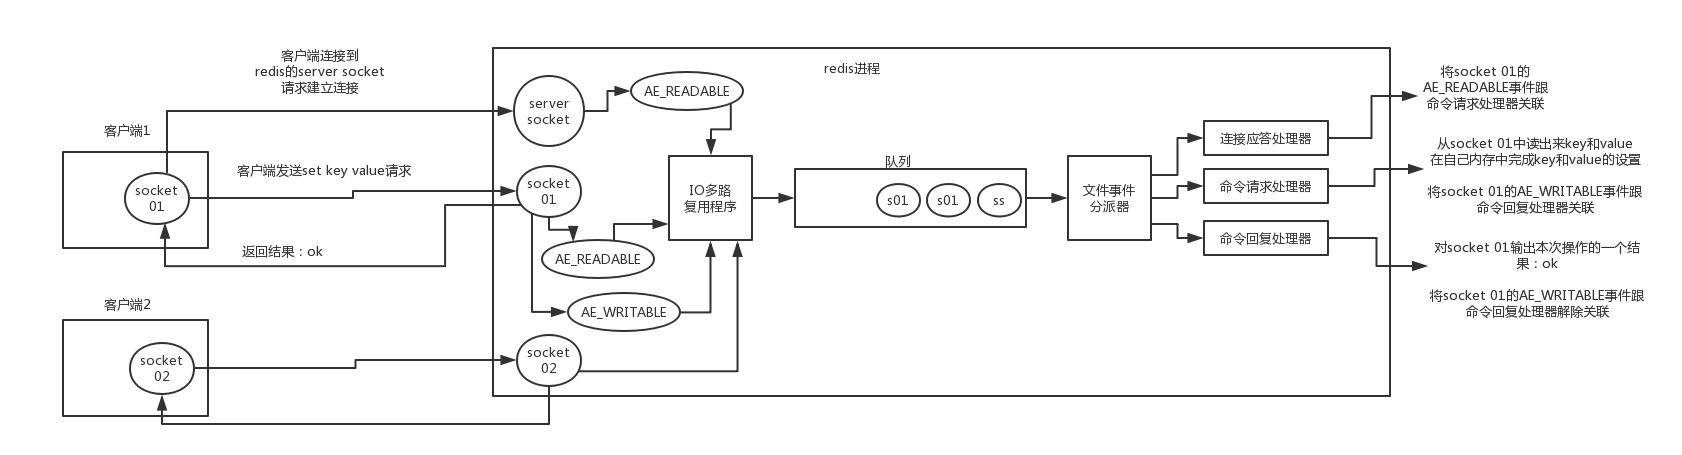
Redis单线程为什么有很高的效率
1、核心是非阻塞的IO多路复用机制,负责监听轮询所有socket,之后放入一个队列中
2、纯内存操作(事件分派器和时间处理器操作)
3、单线程避免了多线程频繁上下文切换问题
Redis过期策略和内存淘汰机制
过期策略
当存入的数据到过期时间时采用定期删除+惰性删除对key删除。
所谓定期删除就是Redis每隔100ms就随机抽取一些设置了过期时间的key,检查是否过期,过期则删除(注意:redis并不会遍历所有设置过期时间的key);定期删除会导致很多过期数据没有删掉,惰性删除:在获取某个key时,redis会检查是否过期,如果过期则删除。
内存淘汰机制
1、allkeys-lru:当内存不足以容纳新写入数据时,在键空间中,移除最近最少使用的key(这个是最常用的)
2、noeviction:当内存不足以容纳新写入数据时,新写入操作会报错
3、allkeys-random:当内存不足以容纳新写入数据时,在键空间中,随机移除某个key
4、volatile-lru:当内存不足以容纳新写入数据时,在设置了过期时间的键空间中,移除最近最少使用的key
5、volatile-random:当内存不足以容纳新写入数据时,在设置了过期时间的键空间中,随机移除某个key
6、volatile-ttl:当内存不足以容纳新写入数据时,在设置了过期时间的键空间中,有更早过期时间的key优先移除
如何保证Redis支持高并发并且是高可用的
单机Redis的QPS在几万,不太可能超过10万(排除性能特别高的机器)
读写分离:一般读的请求远远少于写的请求;架构做成主从架构,一主多从,主负责写,并且采用异步的方式将数据同步到其他slave节点,从节点负责读,所有的读请求全部走从节点。采用主从架构,建议必须开启master node持久化,假如关闭持久化,在master宕机重启时数据是空的,master就会将空的数据集同步到slave上去,所有slave的数据全部清空
主从架构的核心原理:当启动一个slave node的时候,它会发送一个PSYNC命令给master node,如果这是slave node重新连接master node,那么master node仅仅会复制给slave部分缺少的数据; 否则如果是slave node第一次连接master node,那么会触发一次full resynchronization,开始full resynchronization的时候,master会启动一个后台线程,开始生成一份RDB快照文件,同时还会将从客户端收到的所有写命令缓存在内存中。RDB文件生成完毕之后,master会将这个RDB发送给slave,slave会先写入本地磁盘,然后再从本地磁盘加载到内存中。然后master会将内存中缓存的写命令发送给slave,slave也会同步这些数据。slave node如果跟master node有网络故障,断开了连接,会自动重连。master如果发现有多个slave node都来重新连接,仅仅会启动一个rdb save操作,用一份数据服务所有slave node。 水平扩容:如果读的QPS增加,则继续增加redis的slave节点即可。
redis cluster
介绍
支撑N个redis master node,每个master node都可以挂载多个slave node
读写分离的架构,对于每个master来说,写就写到master,然后读就从mater对应的slave去读
高可用,因为每个master都有salve节点,那么如果mater挂掉,redis cluster这套机制,就会自动将某个slave切换成master
redis cluster(多master + 读写分离 + 高可用)
高可用性与主备切换原理
1、判断节点宕机
如果一个节点认为另外一个节点宕机,那么就是pfail,主观宕机
如果多个节点都认为另外一个节点宕机了,那么就是fail,客观宕机,跟哨兵的原理几乎一样,sdown,odown
在cluster-node-timeout内,某个节点一直没有返回pong,那么就被认为pfail
如果一个节点认为某个节点pfail了,那么会在gossip ping消息中,ping给其他节点,如果超过半数的节点都认为pfail了,那么就会变成fail
2、从节点过滤
对宕机的master node,从其所有的slave node中,选择一个切换成master node
检查每个slave node与master node断开连接的时间,如果超过了cluster-node-timeout * cluster-slave-validity-factor,那么就没有资格切换成master
这个也是跟哨兵是一样的,从节点超时过滤的步骤
3、从节点选举
哨兵:对所有从节点进行排序,slave priority,offset,run id
每个从节点,都根据自己对master复制数据的offset,来设置一个选举时间,offset越大(复制数据越多)的从节点,选举时间越靠前,优先进行选举
所有的master node开始slave选举投票,给要进行选举的slave进行投票,如果大部分master node(N/2 + 1)都投票给了某个从节点,那么选举通过,那个从节点可以切换成master
从节点执行主备切换,从节点切换为主节点
RDB和AOF两种持久化机制的介绍
RDB持久化机制,对redis中的数据执行周期性的持久化
AOF机制对每条写入命令作为日志,以append-only的模式写入一个日志文件中,在redis重启的时候,可以通过回放AOF日志中的写入指令来重新构建整个数据集
如果我们想要redis仅仅作为纯内存的缓存来用,那么可以禁止RDB和AOF所有的持久化机制
通过RDB或AOF,都可以将redis内存中的数据给持久化到磁盘上面来,然后可以将这些数据备份到别的地方去,比如说阿里云,云服务
如果redis挂了,服务器上的内存和磁盘上的数据都丢了,可以从云服务上拷贝回来之前的数据,放到指定的目录中,然后重新启动redis,redis就会自动根据持久化数据文件中的数据,去恢复内存中的数据,继续对外提供服务
如果同时使用RDB和AOF两种持久化机制,那么在redis重启的时候,会使用AOF来重新构建数据,因为AOF中的数据更加完整
RDB和AOF到底该如何选择:
(1)不要仅仅使用RDB,因为那样会导致你丢失很多数据
(2)也不要仅仅使用AOF,因为那样有两个问题,第一,你通过AOF做冷备,没有RDB做冷备,来的恢复速度更快; 第二,RDB每次简单粗暴生成数据快照,更加健壮,可以避免AOF这种复杂的备份和恢复机制的bug
(3)综合使用AOF和RDB两种持久化机制,用AOF来保证数据不丢失,作为数据恢复的第一选择; 用RDB来做不同程度的冷备,在AOF文件都丢失或损坏不可用的时候,还可以使用RDB来进行快速的数据恢复
缓存雪崩和缓存穿透
缓存雪崩
现象:由于缓存机器宕机,导致大量用户请求全部落在数据库上,将数据库打崩。
解决方案:
事发前:实现Redis高可用(主从架构+哨兵或者Redis Cluster),尽量避免这种挂掉的情况发生
事发中:设置本地缓存(ehcache)+限流(hystrix)
事发后:Redis持久化,重启后自动从磁盘加载数据,快速恢复缓存数据
缓存穿透
现象:大量请求缓存不存在的数据,导致大量请求打到数据库,搞垮数据库
解决方案:
由于请求的参数是不合法的(每次都请求不存在的参数),于是可以使用布隆过滤器(BloomFilter:将所有可能存在的数据哈希到一个足够大的bitmap中,一个一定不存在的数据会被这个bitmap过滤掉)或者压缩filter提前拦截,不合法就不让这个请求到数据库层!
当从数据库找不到的时候,也将这个空对象设置到缓存里边去。下次再请求的时候,就可以从缓存里边获取了。
数据库和缓存双写时不一致问题分析与解决方案
Cache Aside Pattern(经典的缓存+数据库读写的模式)
1、读的时候,先读缓存,如缓存没有则读数据库并放入缓存,最后返回响应
2、更新的时候,先删除缓存,在更新数据库
为什么是删除缓存,而不是更新缓存呢?
1、高并发环境下,无论是先操作数据库还是后操作数据库而言,如果加上更新缓存,那就更加容易导致数据库与缓存数据不一致问题。(删除缓存直接和简单很多)
2、如果每次更新了数据库,都要更新缓存【这里指的是频繁更新的场景,这会耗费一定的性能】,倒不如直接删除掉,。等再次读取时,缓存里没有,那我到数据库找,在数据库找到再写到缓存里边(体现懒加载)
高并发场景下Cache Aside Pattern会出现的问题及解决方案
问题:
线程A删除了缓存
线程B查询,发现缓存已不存在
线程B去数据库查询得到旧值
线程B将旧值写入缓存
线程A将新值写入数据库
所以也会导致数据库和缓存不一致的问题。
解决方案:
将删除缓存、修改数据库、读取缓存等的操作积压到队列里边,实现串行化。
详细步骤:
更新数据的时候,根据数据的唯一标识,将操作路由之后,发送到一个jvm内部的队列中
读取数据的时候,如果发现数据不在缓存中,那么将重新读取数据+更新缓存的操作,根据唯一标识路由之后,也发送同一个jvm内部的队列中
一个队列对应一个工作线程,每个工作线程串行拿到对应的操作,然后一条一条的执行
这样的话,一个数据变更的操作,先执行,删除缓存,然后再去更新数据库,但是还没完成更新
此时如果一个读请求过来,读到了空的缓存,那么可以先将缓存更新的请求发送到队列中,此时会在队列中积压,然后同步等待缓存更新完成
这里有一个优化点,一个队列中,其实多个更新缓存请求串在一起是没意义的,因此可以做过滤,如果发现队列中已经有一个更新缓存的请求了,那么就不用再放个更新请求操作进去了,直接等待前面的更新操作请求完成即可
待那个队列对应的工作线程完成了上一个操作的数据库的修改之后,才会去执行下一个操作,也就是缓存更新的操作,此时会从数据库中读取最新的值,然后写入缓存中
如果请求还在等待时间范围内,不断轮询发现可以取到值了,那么就直接返回; 如果请求等待的时间超过一定时长,那么这一次直接从数据库中读取当前的旧值
高并发的场景下,该解决方案要注意的问题:
(1)读请求长时阻塞:由于读请求进行了非常轻度的异步化,所以一定要注意读超时的问题,每个读请求必须在超时时间范围内返回
(2)多服务实例部署的请求路由:可能这个服务部署了多个实例,那么必须保证说,执行数据更新操作,以及执行缓存更新操作的请求,都通过nginx服务器路由到相同的服务实例上
(3)热点数据的路由问题,导致请求的倾斜:万一某条数据的读写请求特别高,全部打到相同的机器的相同的队列里面去了,可能造成某台机器的压力过大